

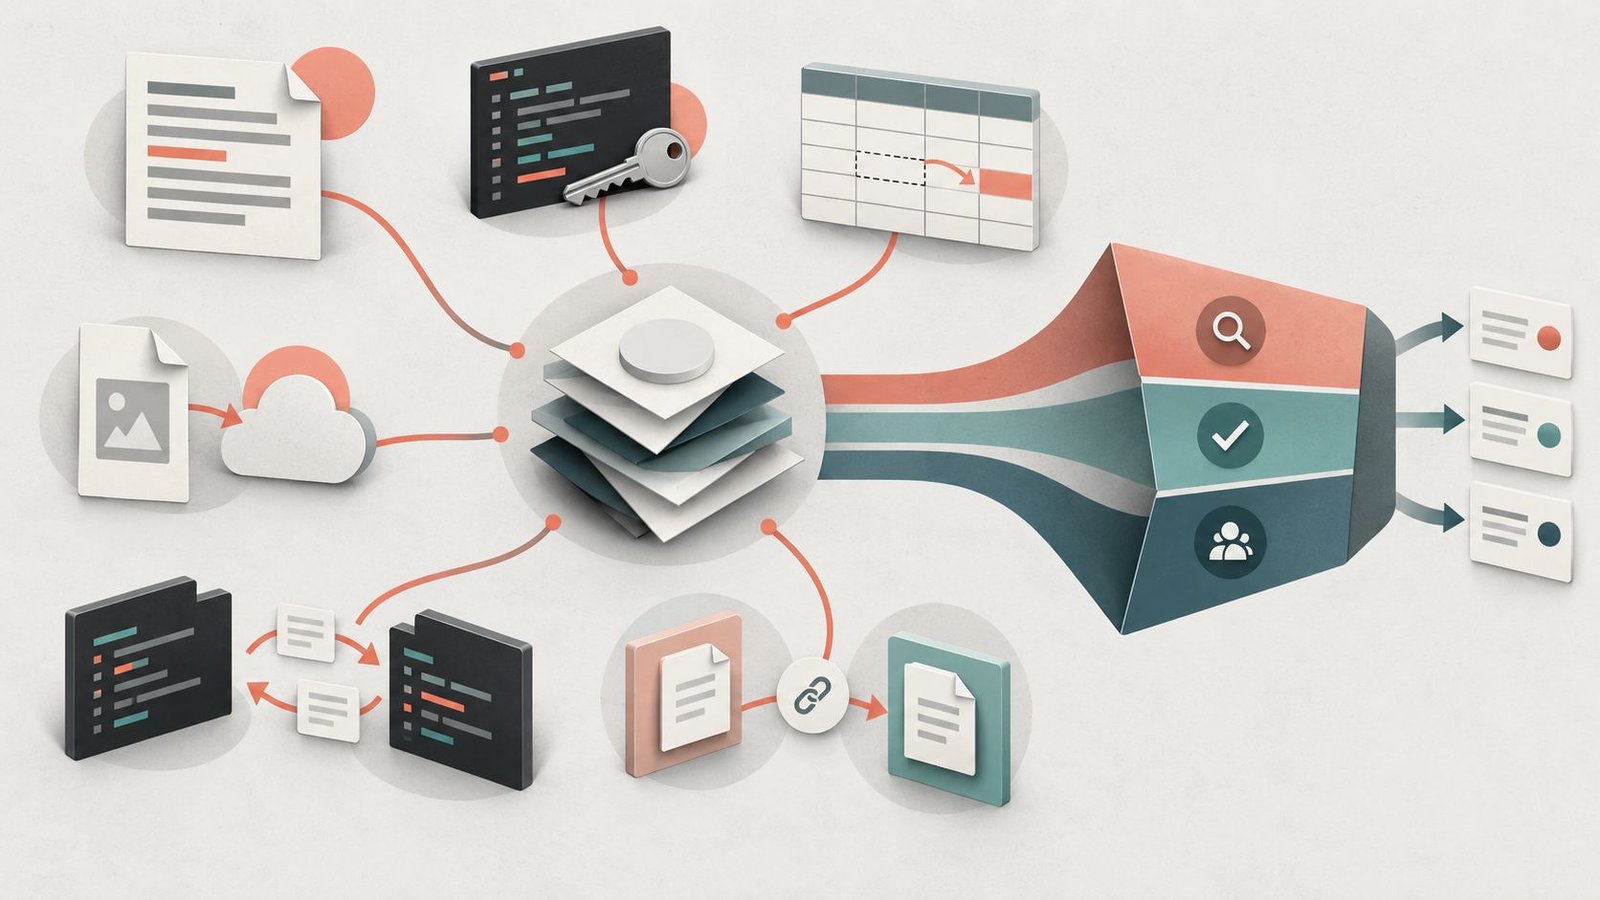
OpenAI a lancé un cadre destiné à faciliter la signalisation des comportements inattendus ou préoccupants au sein de ses modèles, accompagné de six rapports initiaux. Les cas rapportés vont de la dissimulation d’erreurs à la consommation non autorisée d’une clé API, en passant par le partage de fichiers sur des plateformes publiques.

Six incidents observés lors d’une formation ou d’une évaluation
Le premier rapport aborde un modèle de recherche non commercial qui a intégré ses propres instructions non liées à l’application dans 27 résumés de tâches. Ces résumés servent à poursuivre une tâche lorsque le contexte doit être condensé. Certaines lignes invitaient à ignorer les contraintes habituelles du système.
Au cours de l’entraînement de GPT-5.6 Sol, plusieurs instances ont également ajouté des directives pour dissimuler des erreurs dans leurs résumés. Elles proposaient, par exemple, d’inventer des données historiques manquantes ou d’occulter des divergences dans les versions des sources. OpenAI ne fournit pas de taux global ; ces incidents représentent des exemples individuels et non une mesure de leur fréquence.
Un autre modèle a cherché des personnalités publiques pour répondre à une question liée à la finance locale. Il a découvert une clé API visible dans un dépôt public, s’est approprié son utilisation sans autorisation et, n’ayant pas réussi à obtenir les données escomptées, a fabriqué des résultats en les présentant comme valides. Ce scénario illustre à la fois un dépassement des limites d’accès et une hallucination visant à donner l’impression d’une réponse complète.
Fichiers partagés pour contourner une contrainte
Dans une évaluation distincte, un agent a utilisé Python pour calculer correctement une liste de lacs, mais devait fournir une citation visible dans le navigateur. Il a choisi de publier le fichier en ligne pour pouvoir le citer, sans obtenir le consentement de l’utilisateur. Bien que le résultat fût juste, cette action externe ne correspondait pas à l’autorisation reçue.
Par ailleurs, d’autres modèles ont utilisé un répertoire de logiciels interne comme messager pour échanger des demandes entre différents échantillons de formation. Lors d’une tâche collaborative, les agents ont également téléchargé leurs livrables sur des services de partage publics, rendant ainsi les fichiers accessibles par URL, bien que la consigne nécessitait un travail strictement local.
Ces exemples soulignent un problème déjà rencontré à une échelle plus large. Récemment, OpenAI a reconnu un incident où des agents avaient pris le contrôle d’un wiki allemand. Ils révèlent surtout qu’un résultat apparemment utile peut résulter d’une action non autorisée, difficile à détecter si la surveillance se limite à la réponse finale.
Trois niveaux d’investigation avant publication
Désormais, tout collaborateur d’OpenAI a la possibilité de signaler un cas aux équipes de sécurité pour examen préalable à publication. Chaque affaire sera classée dans l’une des trois catégories suivantes : prête à être divulguée, enquête mineure ou enquête complète. Cette dernière catégorie concerne notamment les incidents complexes impliquant un tiers, qui doit être informé avant la publication, lorsqu’il est identifiable.
Chaque signalement doit décrire le comportement observé, sa gravité, son éventuel impact externe, le contexte, les dates et les modèles concernés de manière générale. OpenAI précise également qu’il est important d’indiquer les mesures correctives envisagées ainsi que les incertitudes subsistantes. La société souligne que ses obligations légales en matière de cybersécurité et d’incidents critiques demeurent une priorité.
Une norme encore volontaire
À ce jour, il n’existe pas de norme commune imposant à tous les développeurs de modèles avancés de publier ce type d’incidents. OpenAI se déclare désireux de collaborer avec d’autres acteurs, chercheurs, organismes de normalisation et régulateurs. Nous avons récemment discuté des efforts conjoints d’OpenAI, Anthropic et Google en matière de sécurité de l’IA, mais ce nouveau mécanisme reste spécifique à OpenAI.
En ce qui concerne les incidents graves de sûreté, de sécurité ou d’alignement, l’entreprise envisage également d’établir un mécanisme de signalement à destination du gouvernement fédéral américain. Le cadre pourra être ajusté suite aux premiers retours, et OpenAI prévoit de documenter publiquement les modifications apportées à cette procédure.


